단어 뜻을 불러오는 기능을 내 사이트에 붙이려면 뭐부터 해야 할까요? 사전 데이터를 크롤링해야 하나 고민했는데, 다행히 국립국어원이 오픈 API를 무료로 열어두고 있어요. 결론부터 말하면 한국어 학습자용 쉬운 뜻풀이가 필요하면 한국어기초사전 API, 국어사전 원문 그대로가 필요하면 표준국어대사전 API를 신청하고, 발급받은 인증키를 요청 주소에 붙여 호출하면 끝입니다. 문제는 그 사이에 있는 인증키 오류, XML 응답, 한글 깨짐 같은 자잘한 벽이에요. 코딩을 제대로 배운 적 없는 사람이 Claude Code를 옆에 두고 이 벽을 하나씩 넘는 순서를 그대로 정리했습니다.
- 한국어 기초 사전 API, 결론부터 말하면 이걸 쓰면 됩니다
- 표준국어대사전·우리말샘·한국어기초사전, 뭐가 다른가요
- 인증키 발급, 5단계면 끝납니다
- 요청 주소와 파라미터 뜯어보기
- 응답 구조 읽는 법: JSON이 처음이라면
- Claude Code로 단어 검색 페이지 만들기
- 인증키 오류와 한글 인코딩, 여기서 제일 많이 막힙니다
- 호출 제한·캐싱·라이선스, 운영 단계에서 챙길 것
- 자주 묻는 질문
- 참고자료
한국어 기초 사전 API, 결론부터 말하면 이걸 쓰면 됩니다
📌 핵심 요약
국립국어원 한국어기초사전(krdict) 오픈 API에 회원가입 후 신청해 인증키를 받고, 검색 요청 주소에 인증키와 검색어를 붙여 호출하면 단어 뜻풀이 데이터를 받아올 수 있습니다. 무료이며 신청 즉시 또는 짧은 검토 후 사용 가능합니다.
사전 데이터를 다루는 방법은 크게 세 가지예요. 웹사이트를 크롤링하거나, 사전 파일을 통째로 내려받거나, 공식 API를 호출하는 것이죠. 이 중에서 초보자가 가장 안전하고 빠르게 갈 수 있는 길은 공식 API입니다.
크롤링은 저작권과 서비스 약관 문제가 걸리고, 사이트 구조가 바뀌면 코드가 통째로 깨져요. 반면 국립국어원 오픈 API는 국가기관이 공식적으로 열어둔 통로라서 주소가 잘 바뀌지 않고, 출처만 제대로 표기하면 개인 프로젝트에 쓰기 좋습니다.
여기서 "API"라는 말이 어렵게 느껴진다면 이렇게 생각하면 돼요. 식당 창구에 주문서를 내밀면 음식이 나오는 것과 같습니다. 내가 특정 주소로 "사과라는 단어 뜻 주세요"라고 요청을 보내면, 서버가 정해진 형식으로 데이터를 돌려주는 거죠. 그 주소가 요청 URL이고, 주문서에 적는 항목이 파라미터, 돌아오는 음식이 응답(response)입니다.
그래서 이 글의 흐름은 단순해요. 어떤 사전을 쓸지 고르고 → 인증키를 받고 → 요청 주소를 만들고 → 돌아온 데이터에서 뜻풀이만 뽑아내고 → 화면에 뿌립니다. 이 다섯 단계 중에 초보자가 실제로 막히는 건 대개 두 번째와 네 번째예요.
표준국어대사전·우리말샘·한국어기초사전, 뭐가 다른가요
국립국어원이 운영하는 사전이 여러 개라 처음엔 헷갈립니다. 이름이 비슷해 보여도 대상 독자와 데이터 성격이 확연히 달라요. 잘못 고르면 나중에 데이터 형식을 통째로 다시 맞춰야 합니다.
| 사전 | 성격 | 이럴 때 선택 |
|---|---|---|
| 한국어기초사전 | 한국어 학습자용. 쉬운 뜻풀이, 예문, 다국어 번역 제공 | 학습 앱, 어휘 퀴즈, 초보자용 단어장, 외국인 대상 서비스 |
| 표준국어대사전 | 규범 사전. 한자어·전문어까지 포함한 정통 국어사전 | 맞춤법·표준어 확인, 문서 검수, 어휘 데이터 분석 |
| 우리말샘 | 개방형 사전. 신어·방언·전문용어까지 폭넓게 수록 | 신조어 대응, 넓은 표제어 커버리지가 필요할 때 |
| 민간 검색 API | 포털 검색 결과 기반. 사전 전용 API는 제한적 | 백과·블로그 등 검색 결과를 함께 붙이고 싶을 때 |
정리하면 기준은 하나예요. 내 서비스의 독자가 뜻풀이를 읽고 바로 이해할 수 있어야 하는가? 그렇다면 한국어기초사전입니다. 표준국어대사전은 뜻풀이 자체에 어려운 한자어가 섞여 있어서, 초등학생이나 한국어 학습자에게 그대로 보여주면 오히려 더 어렵거든요.
예를 들어 "사과"를 검색하면 기초사전은 과일 사과와 미안함을 표하는 사과를 학습자 눈높이 문장으로 나눠 보여주고 예문까지 붙여줍니다. 표준국어대사전은 훨씬 촘촘한 대신 문어체 정의가 많아요.
💡 꼭 알아두세요
사전마다 API 신청 페이지와 인증키가 각각 따로입니다. 한국어기초사전 키로 표준국어대사전을 호출하면 인증 실패가 납니다. 두 개를 다 쓸 계획이면 처음부터 각각 신청해두세요.
인증키 발급, 5단계면 끝납니다
인증키(API Key)는 "이 요청은 내가 보낸 게 맞다"를 증명하는 비밀번호 같은 문자열이에요. 서버 입장에서는 누가 얼마나 호출하는지 세야 하니까 이걸 요구합니다.
해당 사전 사이트 회원가입
한국어기초사전은 krdict.korean.go.kr, 표준국어대사전은 stdict.korean.go.kr 로 접속해 회원가입을 합니다. 두 사이트는 계정이 별개인 경우가 있으니 로그인 후 오픈 API 메뉴가 보이는지 먼저 확인하세요.
오픈 API 신청 페이지 이동
사이트 하단이나 상단 메뉴의 "오픈 API" 항목을 찾습니다. 소개 → 신청 → 활용 안내 순서로 구성돼 있는 경우가 많아요. 신청 버튼이 안 보이면 로그인 상태가 아닐 확률이 높습니다.
활용 목적과 서비스 URL 입력
여기서 많이 멈칫합니다. 아직 사이트가 없다면 로컬 테스트 주소(http://localhost:3000)나 준비 중인 도메인을 적고, 활용 목적은 "개인 학습용 단어 검색 페이지 제작" 정도로 구체적으로 한두 문장 쓰면 충분해요.
인증키 확인 및 보관
승인되면 마이페이지나 신청 내역에서 긴 영문·숫자 조합의 키를 확인할 수 있습니다. 즉시 발급되는 경우도 있고 담당자 검토 후 처리되기도 하니, 바로 안 나온다고 재신청을 반복하지 마세요.
브라우저 주소창에서 첫 호출 테스트
코드를 짜기 전에 요청 주소를 그대로 브라우저에 붙여넣어 보세요. 데이터가 화면에 뜨면 키가 살아 있는 겁니다. 이 확인을 건너뛰면 나중에 코드 문제인지 키 문제인지 구분이 안 돼 시간을 두 배로 씁니다.
⚠️ 주의사항
인증키를 프론트엔드 자바스크립트 코드에 그대로 박아 깃허브에 올리면 누구나 가져다 쓸 수 있습니다. 공개 저장소에 올릴 계획이면 .env 파일에 넣고 .gitignore에 추가하세요. 이미 올렸다면 신청 페이지에서 키를 재발급받는 게 안전합니다.
요청 주소와 파라미터 뜯어보기
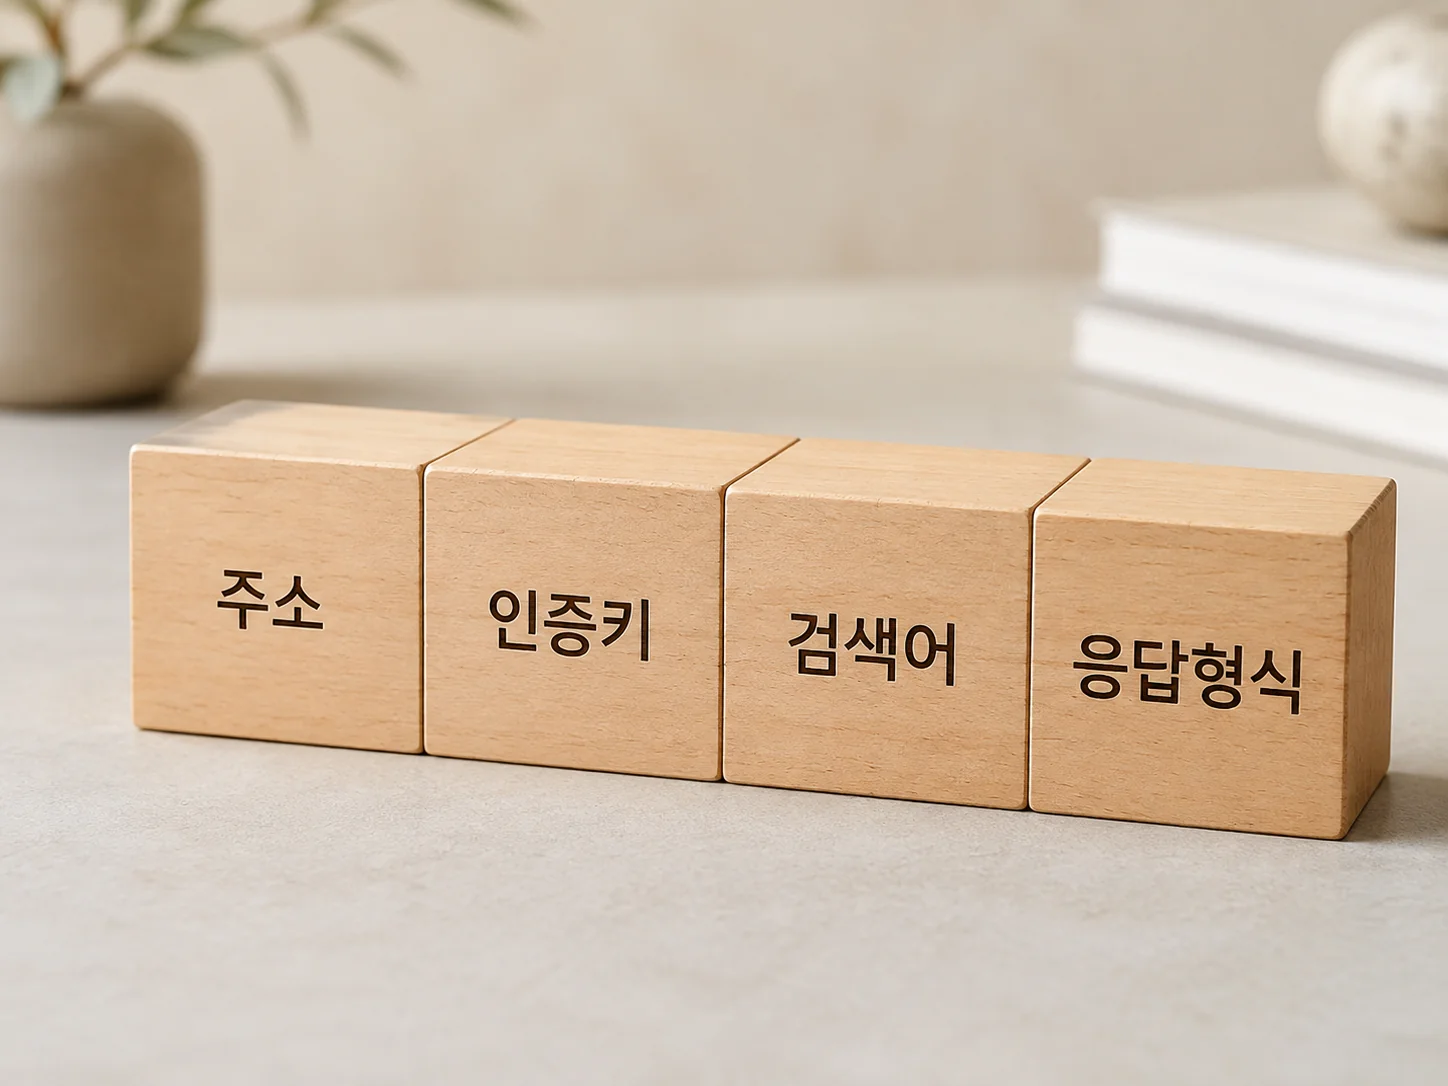
API 요청 주소는 길어 보이지만 구조는 단순해요. 물음표(?)를 기준으로 왼쪽은 "어디로 갈지", 오른쪽은 "무엇을 달라고 할지"입니다. 오른쪽 항목들은 & 기호로 이어 붙여요.
예를 들어 https://주소/api/search?key=인증키&q=사과&req_type=json 이라면, 주소는 검색 창구고 key는 신분증, q는 검색어, req_type은 응답 형식입니다. 이 세 개만 알면 첫 호출은 됩니다.
| 파라미터 | 역할과 주의점 |
|---|---|
| key | 발급받은 인증키. 앞뒤 공백이 섞이면 그대로 인증 실패가 납니다 |
| q | 검색어. 한글은 URL 인코딩이 필요하며 코드에서는 자동 처리되는 경우가 많습니다 |
| req_type | 응답 형식. 지정하지 않으면 기본값이 XML인 경우가 많으니 json을 명시하세요 |
| start / num | 몇 번째 결과부터 몇 개를 받을지. 페이지 넘김 기능을 만들 때 씁니다 |
| part / method | 검색 대상(표제어·뜻풀이·예문)과 일치 방식(완전일치·포함). 결과 품질을 크게 바꿉니다 |
| translated / trans_lang | 학습자용 사전에서 다국어 번역 뜻풀이를 함께 받을지 결정합니다 |
파라미터 이름은 사전마다 조금씩 다릅니다. 그래서 공식 오픈 API 안내 페이지의 파라미터 표를 한 번은 눈으로 훑어야 해요. 남의 블로그 예제를 복사했는데 안 되는 이유가 대부분 여기 있습니다. 다른 사전의 파라미터명을 쓰고 있는 거죠.
또 하나 자주 놓치는 게 "일치 방식"이에요. 기본값이 포함 검색이면 "사과"를 넣었을 때 "사과나무", "사과주"까지 줄줄이 나옵니다. 단어 하나의 뜻만 보여주는 페이지라면 완전일치로 바꾸는 편이 훨씬 깔끔해요.
응답 구조 읽는 법: JSON이 처음이라면
요청이 성공하면 이런 모양의 텍스트 덩어리가 돌아옵니다. 중괄호 { }와 대괄호 [ ]가 잔뜩 있는 형태가 JSON이에요. 중괄호는 "이름표가 붙은 서랍", 대괄호는 "순서대로 줄 선 목록"이라고 생각하면 쉽습니다.
사전 API 응답은 보통 3층 구조예요. 맨 바깥에 검색 요약 정보(총 건수, 현재 페이지)가 있고, 그 안에 검색된 단어들의 목록이 있고, 각 단어 안에 다시 뜻풀이 목록이 들어 있습니다. 한 단어에 뜻이 여러 개일 수 있으니 안쪽도 목록인 거죠.
그래서 화면에 뜻풀이를 뿌리려면 결과 → 항목 목록 → 각 항목 → 뜻풀이 목록 → 정의 텍스트 순서로 두 번 반복문을 돌게 됩니다. 이 경로만 잡으면 나머지는 화면 꾸미기예요.
💡 꼭 알아두세요
응답 구조가 눈에 안 들어오면 받은 JSON을 그대로 복사해 온라인 JSON 뷰어나 브라우저 개발자도구 콘솔에 넣어보세요. 접었다 펼 수 있는 트리로 보여줘서, 어떤 이름표를 따라가야 뜻풀이가 나오는지 5분이면 파악됩니다.
주의할 지점이 하나 더 있어요. 동음이의어 처리입니다. "배" 같은 단어는 과일·신체·탈것이 별개 표제어로 잡혀서, 결과 목록에 서로 다른 항목이 여러 개 옵니다. 이걸 그냥 첫 번째만 보여주면 사용자가 원하는 뜻이 안 나올 수 있어요.
실무에서는 표제어 번호(동형어 번호)를 함께 표시하거나, 품사와 첫 뜻풀이를 나란히 리스트로 보여주고 클릭하면 상세로 넘어가게 만듭니다. 검색 페이지 첫 버전이라면 목록 방식이 만들기도 쉽고 오해도 적어요.
응답 형식을 XML로 받았다면 구조 개념은 같지만 태그로 감싸인 형태라 파싱 코드가 달라집니다. 초보자에게는 JSON이 압도적으로 편하니, 지원한다면 req_type을 json으로 고정하는 걸 권합니다.
Claude Code로 단어 검색 페이지 만들기
여기서부터가 바이브코딩 구간이에요. 코드를 직접 타이핑하는 대신, 원하는 결과를 문장으로 설명하고 AI가 만든 코드를 확인·수정하는 방식입니다. 다만 "사전 검색 페이지 만들어줘" 한 줄로는 원하는 게 안 나와요.
프롬프트에는 최소한 네 가지를 담아야 합니다. 어떤 API를 쓸지(공식 문서 주소 포함), 어떤 화면 구성인지, 응답에서 무엇을 뽑아 보여줄지, 그리고 인증키를 어디에 둘지예요.
📋 프롬프트에 넣을 항목
✓ 화면 구성: 검색창 1개, 결과 카드 목록, 검색 중 표시
✓ 표시할 항목: 표제어, 품사, 뜻풀이, 예문 1개
✓ 인증키는 .env 파일에서 읽고 코드에 하드코딩 금지
✓ 결과가 없을 때와 오류일 때 보여줄 안내 문구
여기서 초보자가 반드시 부딪히는 벽이 하나 있어요. 브라우저에서 바로 API를 부르면 CORS 오류가 납니다. 브라우저가 "다른 도메인의 데이터를 함부로 가져오지 마"라고 막는 보안 규칙이에요. 콘솔에 빨간 글씨로 blocked by CORS policy 라고 뜹니다.
해결 방법은 API 호출을 브라우저가 아니라 서버 쪽에서 하는 겁니다. 간단한 Node.js 서버를 하나 두고, 브라우저는 내 서버에 요청하고, 내 서버가 사전 API를 대신 호출해 결과를 넘겨주는 구조죠. 이걸 프록시라고 불러요. 인증키가 브라우저에 노출되지 않는다는 장점도 덤으로 따라옵니다.
Claude Code에 이렇게 요청하면 흐름이 깔끔해집니다. "프론트는 정적 HTML로 만들고, 사전 API 호출은 Node 서버의 /api/search 경로에서 처리해줘. 인증키는 .env에서 읽고, 응답에서 표제어·품사·뜻풀이만 추려 JSON으로 내려줘."
그리고 코드가 나오면 한 번에 다 실행하지 말고 단계를 쪼개세요. 서버가 뜨는지 → 터미널에서 API 호출이 되는지 → 브라우저 화면에 데이터가 오는지 순서로요. 세 지점 중 어디서 끊기는지 알면 AI에게 물어볼 때도 훨씬 정확한 질문이 됩니다.
인증키 오류와 한글 인코딩, 여기서 제일 많이 막힙니다
첫 호출이 한 번에 성공하는 경우는 드뭅니다. 다행히 막히는 지점은 몇 가지로 정해져 있어요. 증상별로 원인을 미리 알아두면 헤매는 시간이 확 줄어듭니다.
| 증상 | 흔한 원인과 해결 |
|---|---|
| 인증키 오류 메시지 | 복사할 때 앞뒤 공백·줄바꿈이 함께 붙은 경우가 1순위. .env에 따옴표를 감싸 넣어 따옴표까지 키로 전송되는 경우도 흔합니다 |
| 승인 안 된 키 | 신청은 했지만 검토 대기 중일 수 있습니다. 마이페이지에서 상태가 사용 가능인지 확인하세요 |
| 결과가 0건 | 검색어가 인코딩되지 않아 서버가 깨진 문자열로 받은 상태. 또는 완전일치 옵션에 활용형(먹었다)을 넣은 경우 |
| 한글이 ??? 로 표시 | 응답을 UTF-8로 읽지 않은 경우. 파이썬이면 응답 인코딩을 utf-8로 명시하고, HTML에는 meta charset을 넣습니다 |
| CORS 오류 | 브라우저에서 직접 호출한 경우. 서버 프록시를 거치도록 구조를 바꿉니다 |
| JSON 파싱 실패 | req_type을 지정하지 않아 XML이 돌아온 상태. 응답 원문을 그대로 출력해보면 바로 확인됩니다 |
한글 인코딩은 개념만 잡으면 덜 무섭습니다. 컴퓨터는 글자를 숫자로 바꿔 저장하는데, 그 변환표가 여러 종류예요. 보내는 쪽과 받는 쪽이 서로 다른 표를 쓰면 글자가 깨집니다. 요즘은 UTF-8이 사실상 표준이니 모든 구간을 UTF-8로 통일하는 게 답이에요.
URL에 한글을 넣을 때는 또 다른 단계가 필요합니다. 주소창에는 원래 영문·숫자·일부 기호만 들어갈 수 있어서, 한글은 %EC%82%AC 같은 형태로 바꿔 보내야 해요. 이걸 URL 인코딩이라고 합니다. 자바스크립트의 encodeURIComponent, 파이썬 requests의 params 옵션을 쓰면 자동으로 처리돼요.
문제는 수동으로 문자열을 이어 붙일 때 생깁니다. 검색어를 그냥 더해 붙이면 인코딩이 안 된 채로 나가서 결과가 0건이 나오죠. 결과가 계속 비어 있으면 실제로 전송된 최종 URL을 콘솔에 찍어보는 게 가장 빠른 진단입니다.
⚠️ 주의사항
이미 인코딩된 문자열을 한 번 더 인코딩하면 %가 %25로 바뀌어 또 깨집니다. 라이브러리가 자동 처리해주는데 수동 인코딩까지 겹치면 이런 이중 인코딩이 발생해요. 둘 중 하나만 쓰세요.
호출 제한·캐싱·라이선스, 운영 단계에서 챙길 것
테스트할 땐 문제없다가 사이트에 붙이고 나면 새로 보이는 게 있습니다. 공공 오픈 API는 보통 일일 호출 건수 제한이 있어요. 정확한 수치는 사전과 승인 등급에 따라 다르니 공식 안내 페이지에서 확인해야 합니다.
제한을 아끼는 가장 효과적인 방법은 캐싱이에요. 같은 단어를 여러 사용자가 검색하면 매번 API를 부를 이유가 없거든요. 한 번 받아온 결과를 저장해두고 다음부터는 그걸 돌려주면 됩니다.
메모리 캐시로 시작
서버 안에 단어를 키로 하는 저장소를 하나 두고 결과를 담아둡니다. 코드 몇 줄이면 되고, 인기 단어 반복 호출만 막아도 호출량이 눈에 띄게 줄어요. 서버를 재시작하면 사라진다는 점만 감안하세요.
파일이나 DB로 확장
검색량이 늘면 SQLite 같은 가벼운 DB에 단어·뜻풀이·조회일자를 저장합니다. 사전 데이터는 자주 바뀌지 않으니 유효기간을 길게 잡아도 무방해요.
실패 시 재시도와 안내
네트워크 오류나 일시적 응답 지연은 언제든 생깁니다. 1~2회 재시도 후에도 실패하면 사용자에게 "사전 서버 응답이 지연되고 있어요"라고 알려주세요. 빈 화면만 보여주는 게 가장 나쁜 경험입니다.
마지막으로 라이선스입니다. 공공기관 사전 데이터라도 무제한 자유 이용은 아니에요. 사전마다 이용 조건이 다르고, 상업적 이용 가능 여부와 출처 표기 방식이 각각 명시돼 있습니다.
안전한 기본 원칙은 세 가지예요. 첫째, 화면 하단이나 결과 카드에 출처(예: 국립국어원 한국어기초사전)를 표기합니다. 둘째, 뜻풀이를 임의로 고쳐 원문인 것처럼 제공하지 않습니다. 셋째, 광고가 붙는 사이트나 유료 서비스에 쓸 계획이라면 신청 단계에서 활용 목적을 사실대로 적고 이용 약관을 확인하세요.
애드센스를 붙인 블로그에 사전 검색 기능을 넣는 경우도 상업적 이용으로 해석될 여지가 있습니다. 애매하면 해당 사전 사이트의 문의 창구로 물어보는 게 가장 확실해요. 나중에 서비스를 접는 것보다 미리 확인하는 비용이 훨씬 쌉니다.
자주 묻는 질문
한국어기초사전 API와 표준국어대사전 API는 뭐가 다른가요?
뜻풀이의 눈높이와 부가 데이터가 다릅니다. 한국어기초사전은 한국어 학습자를 위해 쉬운 문장으로 정의하고 예문·다국어 번역을 함께 제공해요. 표준국어대사전은 규범 사전이라 표제어 수가 많고 정의가 정밀한 대신 문어체입니다. 인증키와 신청 경로도 각각 별개입니다.
인증키는 무료인가요, 발급까지 얼마나 걸리나요?
국립국어원 오픈 API는 무료로 제공됩니다. 발급 소요 시간은 신청 즉시부터 며칠 검토까지 사전과 시기에 따라 달라지니, 신청 후 마이페이지에서 상태를 확인하세요. 정확한 절차와 제한은 각 사전의 오픈 API 안내 페이지 기준을 따르는 게 맞습니다.
사전 데이터를 파일로 통째로 내려받을 수 있나요?
일부 사전은 사전 내려받기 메뉴나 공공데이터 포털을 통해 배포 파일을 제공합니다. 다만 배포 조건과 갱신 주기가 API와 다르고 용량이 크니, 단순 검색 기능이라면 API 호출이 훨씬 간단해요. 대량 분석이나 오프라인 처리가 목적일 때 파일 배포를 검토하세요.
브라우저에서 바로 호출했는데 CORS 오류가 납니다
서버를 거쳐 호출하도록 구조를 바꾸는 게 정석입니다. 브라우저 보안 정책상 외부 도메인 응답을 막는 것이라 프론트엔드 코드만으로는 우회하기 어려워요. 간단한 Node나 파이썬 서버를 프록시로 두면 CORS도 해결되고 인증키 노출도 막을 수 있습니다.
Claude Code로 만들면 코딩을 전혀 몰라도 되나요?
코드를 직접 쓰지 않아도 되지만, 오류 메시지를 읽고 어디가 문제인지 짚을 최소한의 감각은 필요합니다. API·JSON·인코딩 같은 개념을 대략이라도 알고 있으면 AI에게 훨씬 정확히 질문할 수 있고, 잘못된 코드를 그대로 받아들이는 일도 줄어들어요.
참고자료
- 국립국어원 한국어기초사전 오픈 API 안내 — 신청 절차, 요청 파라미터, 응답 항목이 정리된 공식 페이지
- 표준국어대사전 오픈 API 안내 — 규범 사전 기반 검색 API의 공식 문서
- 우리말샘 — 신어·방언까지 포함한 개방형 국어사전 서비스
- 공공데이터포털 — 사전 외 다양한 공공 API의 인증키 발급과 이용 조건 확인
한국어 기초 사전 API는 진입 장벽이 높아 보이지만, 실제로 넘어야 할 벽은 인증키·요청 주소·응답 구조·인코딩 네 가지뿐이에요. 어떤 사전을 쓸지 먼저 정하고, 브라우저 주소창에서 첫 호출을 확인한 다음, 서버를 프록시로 두고 화면을 붙이는 순서를 권합니다. 이 순서대로 가면 어디서 막혔는지가 명확해서 AI에게 물어볼 때도 질문이 뾰족해져요. 처음부터 예쁜 화면을 만들려 하지 말고, 단어 하나의 뜻이 화면에 뜨는 순간까지만 목표로 잡아보세요. 그 한 번이 되면 예문 추가도, 다국어 번역도, 검색 기록 저장도 전부 응용 문제로 바뀝니다.
함께 보면 좋은 글
